数学从来不只是答案
2026-09-09
一、一个答案,和一种理论
Navier–Stokes 方程我们早就在用,这次OpenAI解决的悬而未决的是它的一个理论极限:正常开始的三维流体,是否一定能永远保持数学上的正常。过去我们不知道是“所有情况都没问题”,还是“存在极少数情况会在有限时间失控”。OpenAI 声称找到了后者的一个严格反例:在光滑外力下,一个最初光滑的流动会在有限时间发生 blowup,因此不存在对应的全局光滑解。
这可以是一项伟大的定理,而它能否成为同样伟大的理论转折,要看接下来我们能从中提炼出什么。而我们真正关注的,是后半句。
数学研究并不是一个简单的:
这里有一个问题 ⟶ 我们不知道答案 ⟶ 知道了就完成任务
我们之所以会几十年、几百年不懈地追逐一些数学问题,是因为这些问题往往有一个共同特点:
持续尝试解决它们,有很高的概率迫使我们创造出新的数学。
 Goodhart’s law
“解题”一直是数学研究围绕的一个重要方向,但它其实同时承担着两种责任:
- 解出这个问题本身;
- 在试图解出它的过程中,锤炼出比答案本身更广泛的知识、方法和理解。
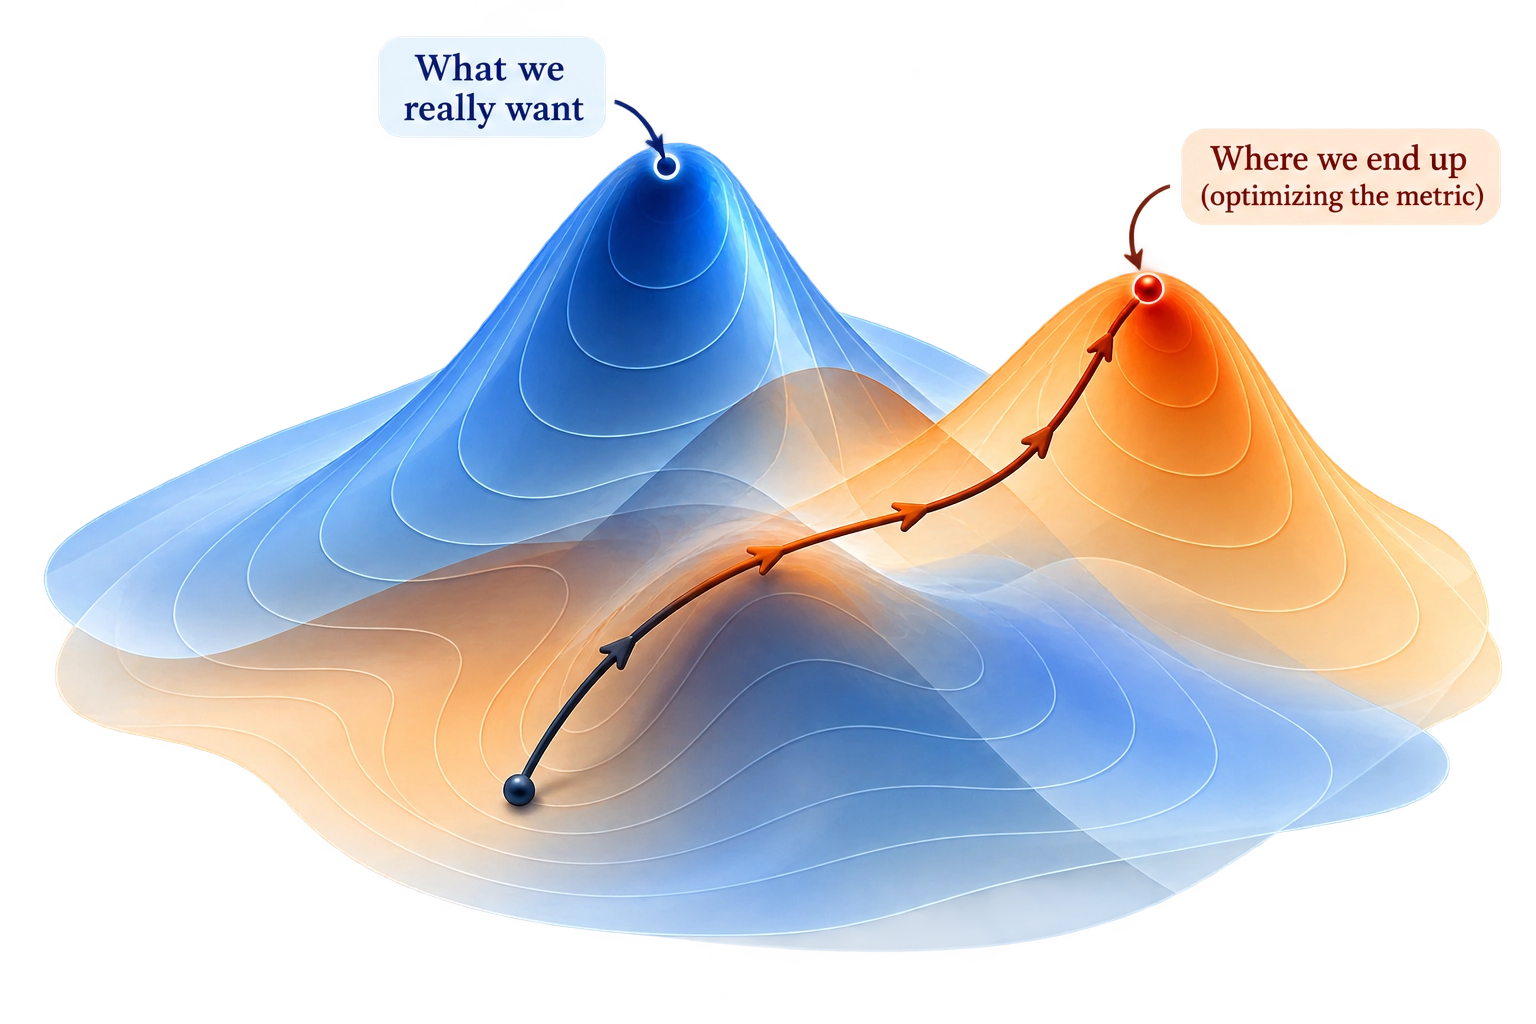
而根据古德哈特定律,一旦我们开始只优化其中那个最容易被看见、被衡量的指标,它就很容易逐渐和原本想代表的东西分离。论文数量原本只是研究进展的一个信号;一旦它本身成了目标,把一个结果拆成几篇、优先去做更容易发表的问题,都能让数字变得更好,而数学却未必因此变得更好。
“解出问题”其实也是一样。我们一直把它当作衡量数学进步的一个很好用的指标,但它从来不是数学进步本身。它之所以长期有效,只是因为在过去,解开一个真正困难的问题,往往会连带地产生新的方法、新的理解,以及下一批能够继续往前走的人。
二、AI 真正拆开的是什么
AI 一次又一次突破各个学科的能力边界,真正迫使我们面对的,却不只是这些行业以后还能不能由人来做,而是我们从事这些事情,到底想从中获得什么。
我们学习知识,当然希望最后能够把题做出来、拿到好的成绩;我们工作,也当然希望把项目真正做成。但这些事情从来都不只有一个结果。一个结果发生在外部:题做出来了,项目上线了,事情完成了。还有一个结果发生在我们自己身上:在那些困惑、判断、失败、调整和重新尝试里面,我们逐渐变成了一个比以前更会处理这类问题的人。
而第二种结果,往往并不会在事情结束的那一刻立刻显现出来。你真正发现自己从上一个大型项目里获得了什么,常常是在下一次一个更复杂的项目来到面前时:上一次形成的判断、经验和处理问题的方式,已经自然地参与进来了。学习也是一样。一道题真正留下来的东西,不只是这一次你知道了答案,而是下一次答案不在你面前的时候,你已经比以前更知道该怎么想。
所以现如今 AI 的能力甚至都不需要强到能够解决真正的数学研究问题,光是帮学生做作业,就已经足够让这个问题出现。AI 很擅长帮我们更快地得到第一个结果,但如果我们没有分清自己究竟把什么交给了它,就可能把原本产生第二个结果的过程也一起外包出去。
问题因此从来都不是“AI 到底应不应该帮我做”。很多机械、重复、并不会真正训练我们所需能力的工作,本来就应该被工具省掉。真正需要问的是:我省掉的只是劳动,还是把那些本来会改变自己的部分也一起省掉了?
如果后者发生了,那么作业完成了,答案正确了,项目也做成了,但是原本应该发生在这个过程里的困惑、试错、判断和成长却都没有发生。我们失去的不只是一个过程,而是本来会长在自己身上的能力。这才是一个真正值得警惕的自我削弱过程。
所以我们真正想保护的,从来都不是什么“所有事情必须由人亲手来做”的自尊感,而是在逻辑可靠性之外,我们还必须继续生产真正可用的认识,也必须让这些认识真正长成我们自己的能力。
三、失败为什么也是数学的一部分
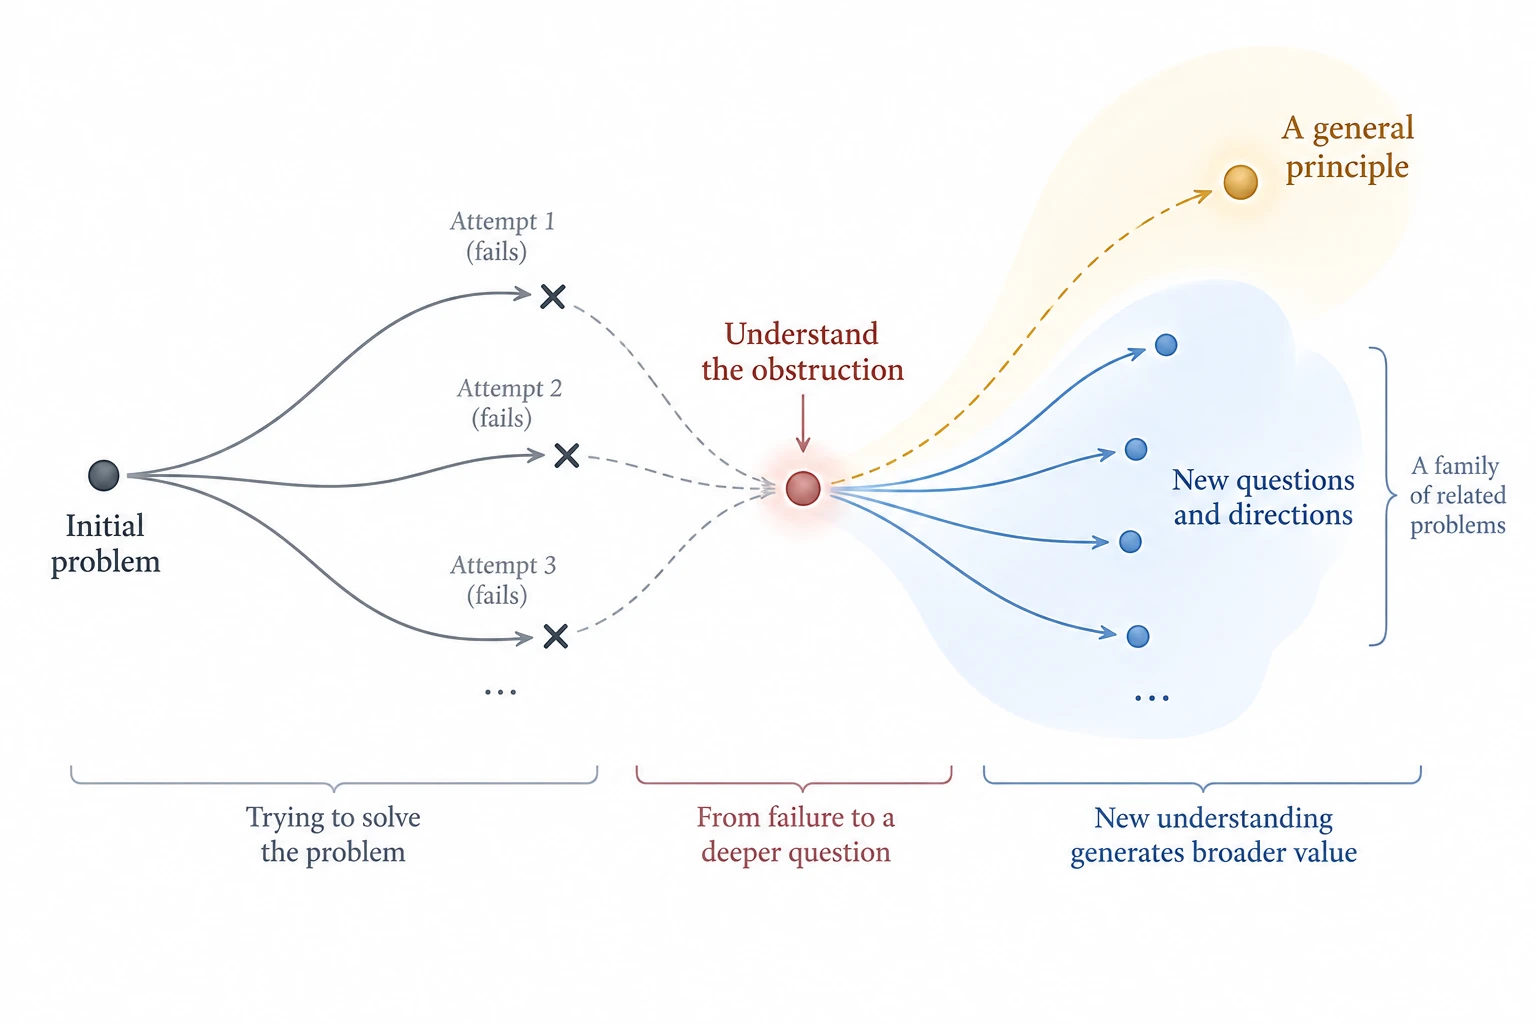
陶哲轩以前专门提到过一个很有意思的反差。我们在高中学习数学的时候,会接受大量训练,就是为了保证自己最后能够把题做对。我们会非常害怕犯错,甚至很难接受一道数学题做错。但是到了真正的数学研究里面,失败反而是数学发展中非常重要的一部分。你试着用一种方法证明一个结论,最后发现它不行,在考试里这可能只是方法错误、答案错误;可是在研究里,如果你能够真正弄明白它为什么不行,你得到的可能是完全不同种类的知识。
一个方法失败以后,真正有价值的问题会慢慢从“为什么我没有把这道题做出来”,变成“究竟是什么东西挡住了这一整类方法”。也许最后你发现,不是自己某一步算错了,而是这类方法本身都缺少一个关键条件。一旦这个障碍被认出来,你得到的就不再只是原来那一道题的答案,而可能是一条以后很多问题都能使用的原则。失败的答案,并不等于失败的研究。有时候,一条被真正理解的死路,本身就在告诉我们数学的边界在哪里。
规则一:f(x) = x
f(1.0) = 1.00
规则二:g(x) = x²
g(1.0) = 1.00
这个样例无法区分两条规则;吻合不等于证明
这也是为什么,对于每一个 AI 作出的数学突破,我其实都会非常期待,也会非常高兴,但同时也会有很大的担心。让我担心的并不是 AI 本身,而是我们围绕知识建立起来的奖励制度。如果这个制度越来越只奖励“谁最先得到答案”,那么一个提前出现的答案,就可能切断原本围绕这个问题发生的其他知识生产活动。一个数学学生、一个年轻研究者原本需要经历的困惑、错误和失败,如果都被最终答案提前跨过去了,这些经历也就很难再自然地转化成认知和理解;而在更大的尺度上,那些本来可能从失败路线中生长出来的方法、问题和理论,也可能因此失去继续被探索的机会。
四、真正稀缺的不是问题
这也就进入了陶哲轩最近讲的另一个非常好的比喻:海水与饮用水。数学当然不缺问题,就像一个被海洋包围的地方并不缺水。你随时都可以制造一个现在没有人知道答案的问题,但真正稀缺的,是那些经过筛选、具有理论生产潜力的问题。制造一个没人知道答案的表达式很容易,判断一个问题是否真的值得某个人投入五年时间,却需要历史知识、方法经验、比较判断,也需要对整个领域的理解。数学真正稀缺的,从来不是问号本身,而是知道哪些问号值得被认真对待。
而在今天,一个研究者也许只是在公开场合说了一句“这个问题现在似乎可攻”,这句话背后却可能压缩了他对这个领域多年的理解、无数次失败、对已有方法边界的熟悉,以及对某个新突破意义的判断。表面上看,他只是给出了一句话;实际上,他可能已经完成了非常昂贵的一步:判断这片巨大的问题空间里,哪里真正值得投入资源。
于是就会出现一种越来越明显的不对称。确定哪里值得挖,可能非常昂贵;但一旦别人已经告诉你矿在哪里,调用强大的工具继续挖下去,可能突然变得非常快。这当然不足以把后来的独立研究简单称作“窃取”,更不意味着最早指出方向的人就拥有这个问题。但如果我们仍然只按照“谁最后完成了证明”来分配全部声望,就很可能系统性地低估“发现哪里值得挖”本身的成本。在一个证明能力越来越丰富的时代,识别什么问题真正值得研究,也许会成为数学中越来越稀缺、越来越重要的一种能力。
五、不要用 AI 的能力定义人的价值
现在很多人每次听到 AI 在科研上又有新的突破,就会本能地感到绝望,然后开始贬低自己的行业,或者问:“那这个行业是不是没有意义了?”我觉得这既不尊重别人,也不尊重自己。如果你真的选择从事一个行业,更重要的问题其实一直都是:我们究竟希望这个行业服务什么?对于数学来说,这个答案并不复杂。数学事业的重要目标之一,是人的理解,以及人通过这种理解彼此连接、培养下一代,并继续探索的能力。
所以,“AI 能否理解得比人更深”是一个能力问题,“人类还有没有必要理解”则是一个价值问题。这两个问题根本不是一回事。就算有一天前一个问题的答案真的变成了肯定,也不会自动回答后一个问题。人类是否还需要理解数学,并不应该取决于另一个系统理解得是不是比我们更快、更深。
当然,我们也必须诚实面对一件事情:我们现在并不能找出一种可以保证永远只有人类、而 AI 永远无法实现的独占数学技能。也许今天我们会说,人类更擅长提出问题,以后未必;我们会说人类更有数学 taste,以后也未必;我们会说只有人类才真正能够理解,这件事情未来也未必还能这样简单地区分。如果我们把人的价值建立在“还有哪些事情 AI 不会做”上,那其实是一种非常脆弱的价值观,因为 AI 每前进一点,人类的价值就必须跟着后退一点。人的价值不应该由 AI 的能力边界来定义。
六、我们真正需要保护的是成长
数学家的工作当然包括得到新的结论,但更重要的一部分,是把一种认识转化成其他人可以独立使用的能力:把一个构造变成一个机制,把一次失败变成一个边界,把一份证明变成一种语言,再把一个人的成果逐渐变成整个共同体可以继续使用的研究能力。一个结果真正进入数学,并不只是因为我们终于知道它是对的,而是因为后来的人可以拿着它继续判断、继续修改、继续推广,甚至继续犯新的错误。
所以,我们最终真正应该用来检验“理解”的,也不是一篇文章是不是把答案解释得很流畅,而是读完之后,一个人有没有因此获得新的判断能力。面对一个新的例子,他能不能判断它是否属于同一种机制;修改一个假设以后,他能不能预见哪里可能出问题;面对一个新的失败,他能不能识别出原本看不见的障碍;离开原来的证明之后,他还能不能提出一个有效的推广。当这些能力真正出现时,一个数学成果才开始从“我知道了一个答案”,变成“我们多了一种以前没有的能力”。
在 AI 快速生长的时代,我们并不需要靠寻找一块机器永远无法进入的领地,来确认人的价值。我们真正需要保护的,是人在使用这些工具的时候,仍然能够形成自己的理解、判断和能力,并把这些东西继续传给别人。我们不需要保护人的自卑情结,也不需要保护某种“所有事情都必须由人亲手完成”的自尊。我们真正需要保护的,是我们的成长。
评论